
Registro de corrección de errores: PDF a Word
Aquí documentaré uno de los errores que cometí y el resultado tras corregirlo.
Cuando estaba desarrollando esta pequeña herramienta para convertir PDF a Word, no noté un error bastante evidente en mi programa: aunque el documento PDF se convirtió correctamente a un documento Word, se perdió la disposición original de las páginas, como este:
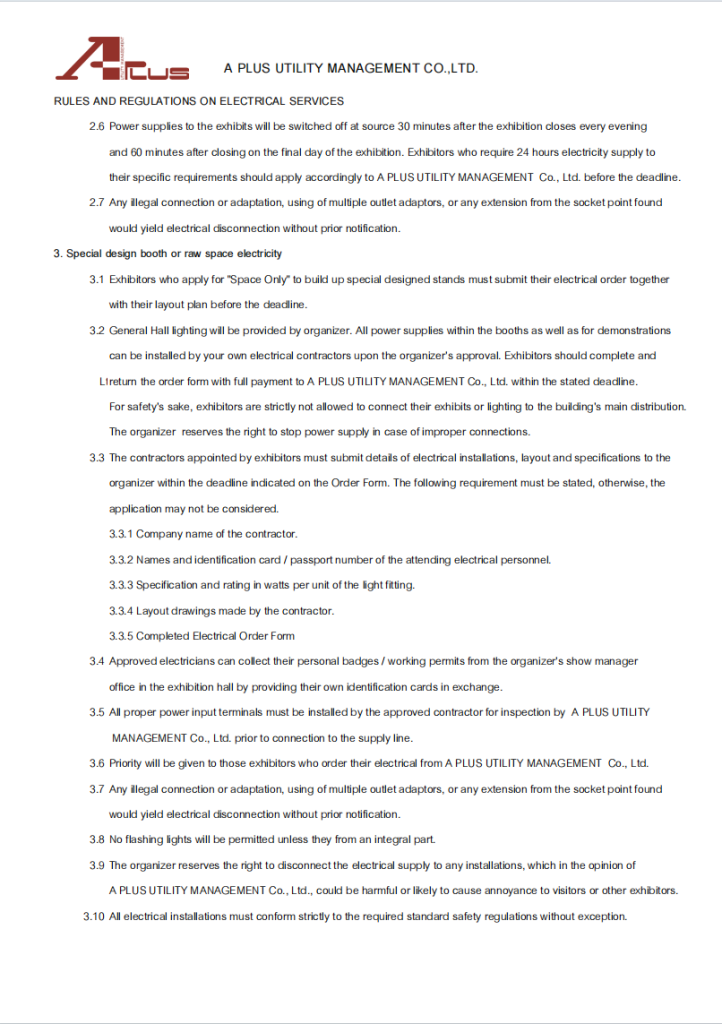
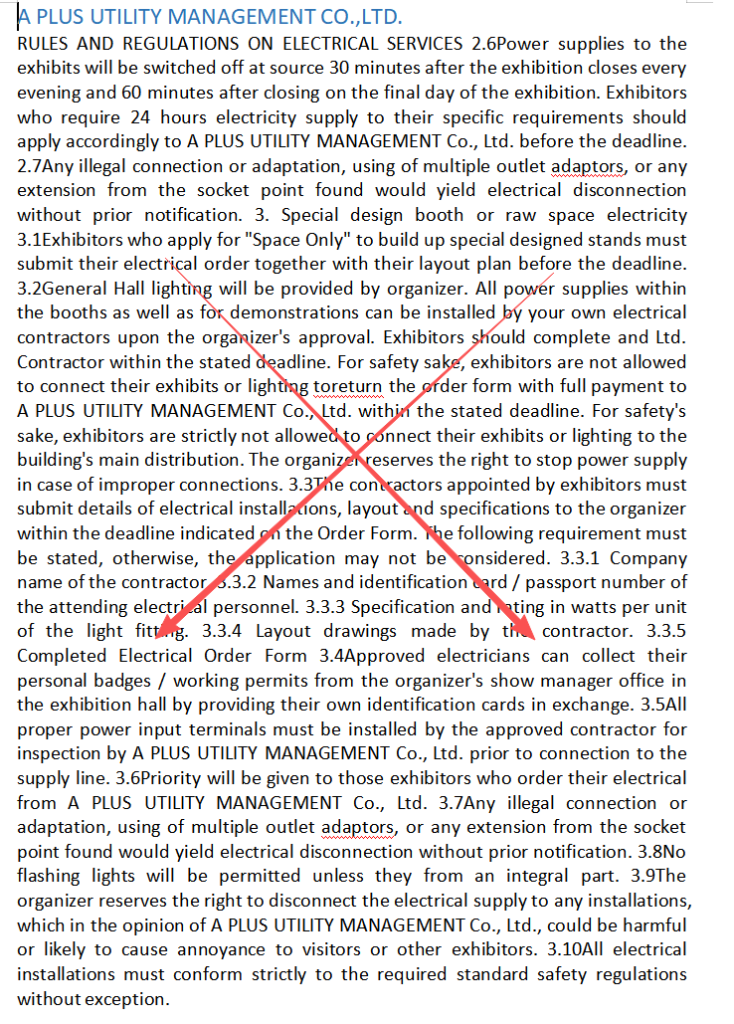
El problema radica en que el motor de conversión solo reconstruía «parágrafos y encabezados», pero no conservaba los elementos de diseño como el alineamiento, el espaciado entre líneas, la sangría, las listas y la configuración de páginas. Como resultado, la salida era simplemente un montón de texto.
Reescribí el motor e incluí una reconstrucción completa del diseño: métodos de alineación línea por línea (centrado/derecha/justificado), espaciado real entre líneas, sangría de primera línea, sangría con puntos suspensivos, detección del orden de lectura en dos columnas, mapeo de familias de fuente serif/sans/mono, y generación de configuraciones de página para Word basadas en el tamaño original de la página y los márgenes del PDF. Esta es la situación modificada:
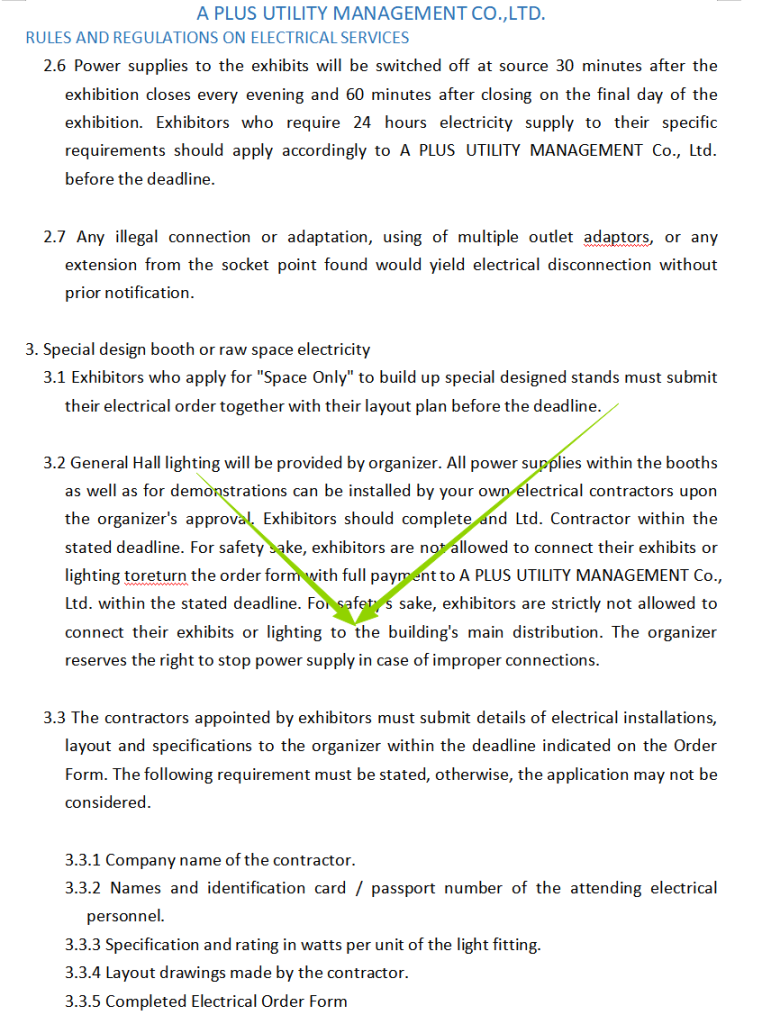
Sin embargo, debo admitir que las imágenes, los bordes de las tablas y los colores aún no se conservan. Este es un límite razonable para una solución puramente de interfaz frontal sin carga. Si se necesita un procesamiento más complejo, puedes utilizar otras herramientas pequeñas en mi sitio web.
Aunque este problema sea pequeño, creo que causará muchos inconvenientes en el uso posterior. Cada vez que un usuario finalice el trabajo de conversión, tendrá que dedicar tiempo a reformatearlo. Si pudiera resolver este problema una sola vez, podría evitar problemas posteriores. Es como lo que la gente suele decir: «¡No dejes el problema para mañana!»